Le prix de la pensée artificielle chute 13 fois par an, un record historique
Epoch AI a mesuré la vitesse à laquelle un niveau donné de performance IA devient bon marché. Aucune technologie de rupture n'a jamais baissé aussi vite.
En bref
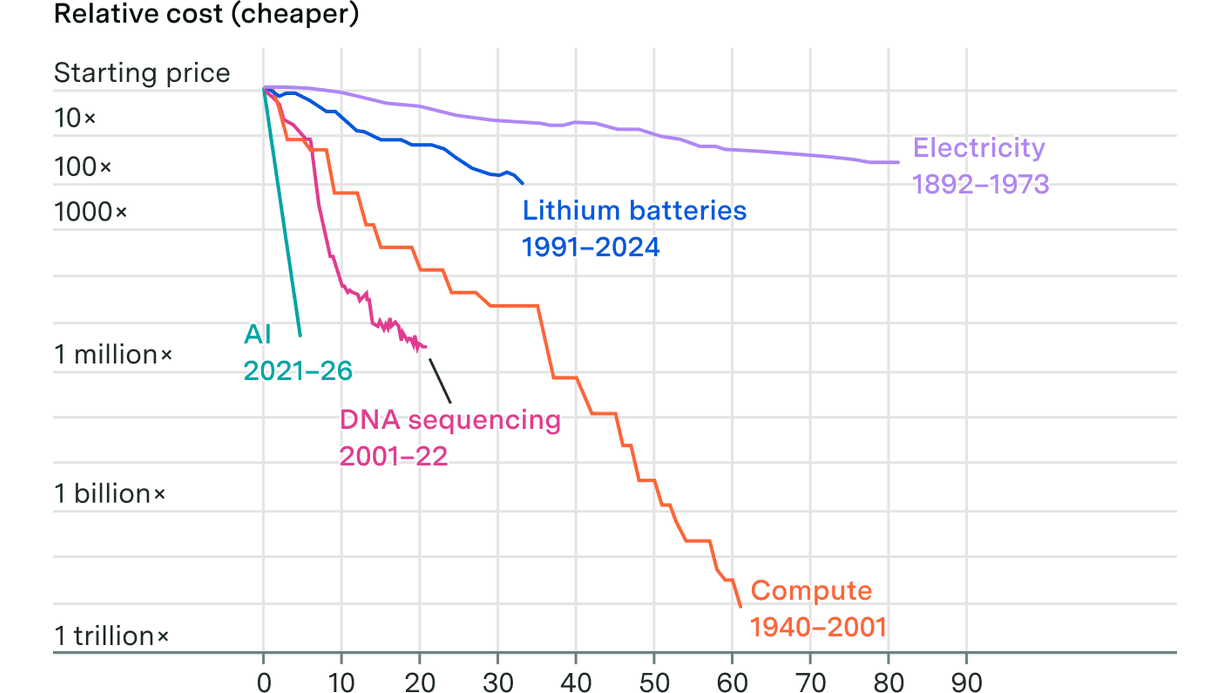
Selon Epoch AI, le coût pour atteindre un niveau de performance donné sur cinq benchmarks (maths, sciences, jeux) a baissé d'environ 47 % par trimestre depuis 2023, soit un facteur 13 par an. C'est bien plus rapide que l'électricité, les batteries, le compute ou le séquençage ADN. La baisse est encore plus violente juste après qu'un niveau de performance devient l'état de l'art, ce qui en dit long sur la fragilité des marges des labos.
🍺 Version comptoir
Une réponse à un QCM de physique niveau doctorat coûtait 30 centimes début 2025 ; dix-huit mois plus tard, elle coûte quatre centièmes de centime. C'est comme si ta voiture neuve passait de 50 000 dollars à 69 dollars, et que le concessionnaire trouvait ça normal. L'électricité a mis quatre-vingts ans à faire beaucoup moins bien, et elle n'a jamais su jouer aux échecs. Sauf que moins cher ne veut pas dire moins de dépenses : quand un truc devient quasi gratuit, on finit par en commander un million.
À retenir
- 1
Depuis 2023, le coût d'un niveau de performance IA fixe baisse d'environ 47 % par trimestre, soit 13x par an, en moyenne sur cinq benchmarks : FrontierMath (tiers 1-3), OTIS Mock AIME, GPQA Diamond, Chess Puzzles et Mystery Game Puzzles.
- 2
Les maths baissent le plus vite (50–52 % par trimestre, 16–19x par an), les puzzles de jeux le moins vite (39–43 %, 7–10x par an).
- 3
Exemple phare : 75 % sur GPQA Diamond coûtait environ 0,30 $ par question avec o3 (janvier 2025), puis 0,0004 $ avec GPT-5.6 Luna moins de 18 mois plus tard, une baisse de 725x.
- 4
Juste après qu'un niveau de performance devient l'état de l'art, le coût chute de 66 % par trimestre (75x par an) ; deux ans plus tard, la baisse ralentit à 32 % par trimestre (4,7x par an).
- 5
En log points, l'inférence LLM a baissé 4 fois plus vite que le séquençage ADN, 6 fois plus vite que le compute, 18 fois plus vite que les batteries lithium-ion et 54 fois plus vite que l'électricité.
- 6
La méthode reconstruit toute la courbe coût-performance de chaque modèle à partir des transcripts de benchmarks, selon une procédure du Center for AI Standards and Innovation (CAISI).
- 7
Les auteurs listent eux-mêmes les limites : benchmaxxing, écart entre benchmark et travail utile, utilisateurs réels qui ne changent pas de modèle en permanence, et seulement trois ans de données.
Un prix de sortie qui s'effondre pendant que les intrants flambent
Le boom de l'IA fait grimper le prix de ce qu'il consomme : puces, électricité, et même la main-d'œuvre des électriciens. Epoch AI s'intéresse au revers paradoxal de ce phénomène : le prix de ce que produisent les data centers baisse à une vitesse inédite.
L'exemple choisi est parlant. Fin janvier 2025, o3 atteignait 75 % sur GPQA Diamond, un QCM de physique, chimie et biologie niveau doctorat, pour environ 30 centimes par question. Moins de 18 mois après, GPT-5.6 Luna obtient le même score pour 0,0004 $.
Soit une baisse de 725x. Le rapport la traduit en image : une voiture neuve dont le prix passerait de 50 000 à 69 dollars.
Mesurer le coût réel, pas le prix du token
Les travaux précédents raisonnaient en prix par token : Guido Appenzeller (a16z) trouvait 10x par an, une première analyse d'Epoch en mars 2025 entre 9 et 900x selon les benchmarks. Les modèles de raisonnement, lancés avec o1, ont rendu cette approche bancale : ils consomment beaucoup plus de tokens mais s'appuient sur des modèles plus petits et moins chers par token.
Epoch mesure donc le coût réel pour atteindre un score. Plutôt que de faire tourner chaque modèle à tous les budgets possibles, l'équipe reprend une méthode du CAISI : à partir d'un run sans contrainte, on compte les questions résolues correctement sous un budget X de tokens, les autres étant notées au hasard. On obtient ainsi une courbe performance-dépense complète.
Pour éviter les biais, l'équipe a comblé ses trous de données en testant des modèles à faible effort de raisonnement et des petits modèles efficaces, y compris des modèles open weight hébergés sur du matériel loué. Validation : sur cinq modèles aussi disponibles via API, l'écart entre coût direct et prix API reste sous 30 %.
Des modèles statistiques assumés comme approximatifs
L'objet étudié est la frontière de Pareto : le modèle le moins cher capable d'atteindre chaque niveau de performance à une date donnée. Une frontière instable par nature, qu'un seul résultat ajouté ou manquant peut déplacer pendant des mois.
Epoch a testé plusieurs approches : ajustement lissé de la frontière, enveloppe contrainte, régression sur toutes les données, analyse de frontière stochastique. Le modèle retenu est un ajustement Box-Tidwell de la frontière des coûts, qui colle aux données sans produire d'inversions absurdes. Les autres donnent parfois des résultats implausibles, comme des coûts qui augmentent.
Les auteurs renoncent explicitement aux intervalles de confiance et au bootstrap, jugés trompeurs dans ce contexte. Le chiffre de 47 % tombe pile sur la moyenne calculée sans modèle, ce qui renforce sa crédibilité.
La prime de l'état de l'art ne dure pas
Sur trois des cinq benchmarks principaux (AIME, FrontierMath, GPQA Diamond), le coût chute le plus vite juste après qu'un niveau de performance est atteint pour la première fois. En moyenne : 66 % par trimestre au moment où ce niveau devient SOTA, 32 % deux ans plus tard.
L'explication avancée : le labo qui décroche un nouveau record facture brièvement une prime, avant que la concurrence et les progrès techniques n'écrasent le prix. Les puzzles d'échecs et de jeu mystère font exception, avec une légère accélération.
Détail notable : la concurrence la plus féroce près de l'état de l'art oppose surtout des modèles fermés. Un seul modèle open weight, QwQ-32B, apparaît en deuxième position dans les exemples étudiés, même si la pression de l'open source peut jouer indirectement.
Une baisse sans équivalent historique
Epoch estime plausible que ce rythme dure depuis novembre 2021, date d'ouverture commerciale de l'API GPT-3. Indice : GPT-3 obtenait 43,9 sur MMLU pour 60 $ le million de tokens ; Llama 2-7B faisait 45,3 en juillet 2023 pour 0,20 $, soit une baisse de 31x par an.
En comparaison, le prix résidentiel de l'électricité aux États-Unis a baissé de 1,05x par an entre 1892 et 1973, les batteries lithium-ion de 1,16x (1991–2024), le compute de 1,51x (1940–2001), le séquençage ADN de 1,84x (2001–2025).
Les limites, posées par les auteurs eux-mêmes
Premier risque : le benchmaxxing, l'entraînement ciblé sur les benchmarks connus. Mystery Game Puzzles, dont le jeu est tenu secret pour l'éviter, affiche une baisse un peu plus lente (44 % contre 47 %), ce qui suggère une critique « valide mais pas fatale ».
Ensuite, un benchmark n'est pas du travail utile, et aucun utilisateur réel ne jongle en permanence entre les modèles pour rester sur la frontière des coûts. Trois ans de données, c'est court, et les choix de moyenne font varier le résultat entre 42,9 % et 58 % par trimestre.
Enfin, prix en baisse ne signifie pas dépense en baisse : une tâche comme vérifier des milliers de papiers scientifiques pourrait exiger l'équivalent d'un million de runs de benchmark. Et si réussir un test de maths de CP est devenu gratuit, prouver des théorèmes difficiles ne l'est pas.
“That is a 725-fold drop in the price of thought in under 18 months.”
“The price of passing a first-grade math test may now be trivial. The price of proving hard theorems is not.”
“Supra-normal profits in LLM service provision may be fleeting for any given model.”
Pourquoi ça compte
Ce rapport donne un ordre de grandeur solide à une intuition diffuse : l'intelligence de niveau donné devient une commodité à une vitesse sans précédent. Deux conséquences méritent l'attention. D'abord, la fenêtre de rentabilité d'un modèle de pointe se referme en quelques trimestres, ce qui explique la course effrénée entre labos et interroge la viabilité de modèles économiques fondés sur des marges premium. Ensuite, la baisse des prix unitaires ne dit rien de la facture totale : si l'usage explose (agents, raisonnement long, traitement massif), la demande en compute peut continuer de croître, ce qui réconcilie ces chiffres avec les investissements colossaux en data centers. L'honnêteté méthodologique d'Epoch est à saluer, mais il faut lire le « 13x par an » comme une mesure de ce qui est possible pour un acheteur parfaitement optimisateur sur des benchmarks académiques, pas comme la baisse de coût vécue par une entreprise qui déploie un assistant de code. Le SWE-bench Verified, plus proche du travail réel, ne baisse d'ailleurs « que » de 27,5 % par trimestre.
Pour vous
Faites-la travailler sur vos sources.
Gratuit : les articles de la semaine et trois de vos sources. Pro : l'archive complète et vos sources, dès 8 €/mois.
Pour votre équipe
La même machine, sur vos sujets.
Un espace à vos couleurs, vos angles de veille, vos curateurs. Pilote ouvert à trois entreprises.
À lire aussi
 #anthropicAujourd'hui
Claude Opus 5.5 : plus fort, 40 % moins cher à faire tourner
Anthropic sort son premier modèle depuis son appel à « ralentir la frontière » — et met l'efficacité au centre du discours.
Source · Anthropic · Introducing Claude Opus 5.5
 #apiAujourd'hui
GPT-6 Sol et Luna : OpenAI divise ses prix API par deux
Après Astra, OpenAI décline sa nouvelle génération en deux modèles moins chers et attaque frontalement Claude sur le rapport coût/intelligence.
Source · OpenAI · Introducing GPT-6 Sol and Luna
 #iaHier
Dans 46 % des entreprises, le DRH n'est pas dans la pièce
L'étude CHRO 2026 d'IBM chiffre ce qui sépare les entreprises qui transforment l'IA en croissance de celles qui la transforment en économies.
Source · IBM Institute for Business Value · Designing the Thinking Organization — 2026 CHRO Study