arXiv plafonne les soumissions à deux par mois face au déluge de papiers IA
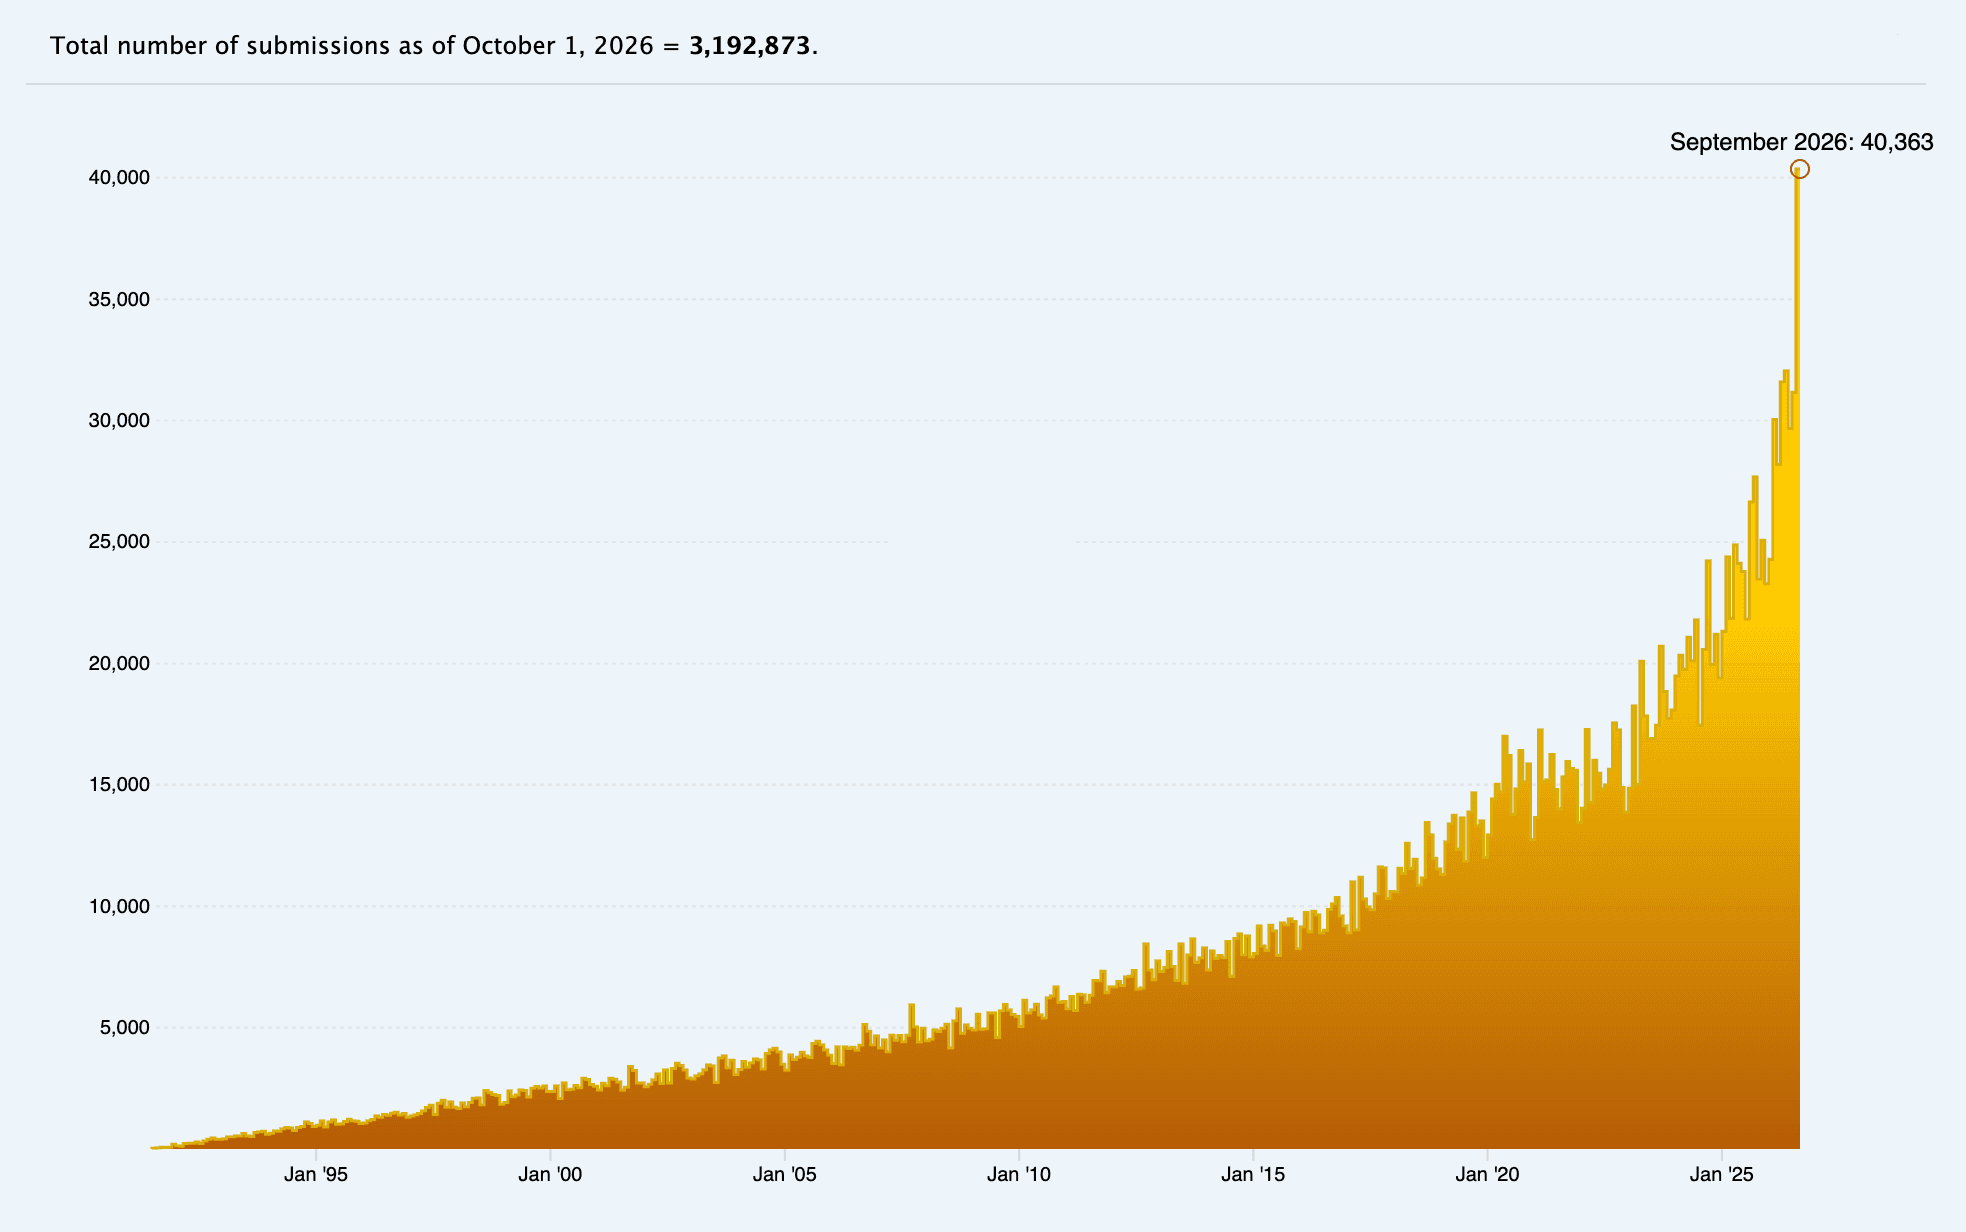
40 363 soumissions en septembre, le double d'il y a deux ans : le dépôt de prépublications le plus influent de la science serre la vis.
Qui en parle
En bref
Depuis le 1er octobre 2026, arXiv limite chaque soumetteur à deux soumissions par mois calendaire et trois soumissions actives simultanées, toutes catégories confondues. La mesure, présentée comme provisoire, répond à l'explosion des papiers minces, découpés en tranches ou rédigés par IA, qui saturent les modérateurs bénévoles. C'est l'un des premiers signaux concrets d'une infrastructure scientifique majeure qui adapte ses règles à la production assistée par IA.
🍺 Version comptoir
arXiv, c'est la grande boîte aux lettres où les chercheurs postent leurs papiers avant publication, et elle déborde : 40 000 envois en un mois, deux fois plus qu'il y a deux ans. Le coupable n'est pas un soudain âge d'or du génie humain, mais des outils d'IA qui permettent de pondre un article comme on remplit une note de frais. Du coup, la règle tombe : deux papiers par mois maximum, refusés compris, un peu comme un restaurant qui limite le buffet parce que trois clients repartaient avec des Tupperware. Quand la science doit rationner les gens qui écrivent, c'est que le goulot d'étranglement n'est plus d'écrire, mais de lire.
À retenir
- 1
Depuis le 1er octobre 2026, chaque soumetteur arXiv est limité à 2 soumissions par mois calendaire et 3 soumissions actives au maximum, toutes catégories confondues.
- 2
arXiv a reçu 40 363 soumissions en septembre 2026, contre 20 569 en septembre 2024 et 9 869 en septembre 2016, générant près de 9 000 tickets de support.
- 3
La catégorie cs.AI a vu ses soumissions multipliées par plus de 6 en deux ans ; les autres catégories ont doublé sur la même période.
- 4
Les modérateurs constatent une hausse des papiers minces, des papiers « salami » (un travail découpé en plusieurs articles) et des textes denses rédigés par IA.
- 5
Les soumissions rejetées comptent dans le quota, car c'est la soumission, et non la publication, qui consomme le temps des modérateurs.
- 6
Le quota ne s'applique qu'au soumetteur, pas aux co-auteurs, et un papier supprimé avant annonce ne compte pas.
- 7
arXiv présente la règle comme un stopgap, le temps de définir de nouvelles bonnes pratiques et d'améliorer ses outils de modération.
Une croissance devenue ingérable
Les chiffres publiés par arXiv parlent d'eux-mêmes : 9 869 soumissions en septembre 2016, 20 569 en septembre 2024, puis 40 363 en septembre 2026. Un record absolu depuis la fondation du dépôt en 1991, et un doublement en seulement deux ans.
Ce volume a un coût opérationnel direct : près de 9 000 tickets de support générés pour le seul mois de septembre. Le phénomène n'est pas propre à arXiv, qui note que l'ensemble des dépôts en open access voit grimper le nombre de soumissions par auteur et par mois.
La catégorie cs.AI concentre le choc, avec une multiplication par plus de six en deux ans. Les autres disciplines, elles, ont « seulement » doublé.
Le diagnostic : l'IA a fait sauter la limite pratique
Avant l'IA, explique arXiv, il existait une limite pratique facile à identifier au rythme auquel un chercheur pouvait produire des travaux indépendants. Les modérateurs bénévoles bridaient au cas par cas ceux qui la dépassaient nettement.
Avec des outils d'IA plus puissants et accessibles, cette limite est devenue floue. arXiv autorise l'usage de l'IA comme outil de recherche, à condition qu'il soit déclaré et que le travail apporte une contribution réelle à son domaine.
Or beaucoup de soumissions récentes ne passent pas ce filtre : papiers minces au périmètre étroit, papiers « salami » qui découpent un travail unique en plusieurs articles, et textes denses visiblement rédigés par IA.
Une question d'équité entre auteurs
Le cœur de la modération d'arXiv repose sur des bénévoles. Thomas Dietterich, président de l'Editorial Advisory Council, pointe le problème : une petite minorité d'auteurs soumet beaucoup de papiers de faible qualité et accapare une part disproportionnée du temps des modérateurs.
Conséquence concrète, les auteurs qui soumettent des travaux sérieux voient leurs papiers retardés de plusieurs jours, voire de semaines. La nouvelle règle vise donc à répartir équitablement ce temps de modération, devenu la ressource rare.
Ce que dit précisément la nouvelle règle
Deux soumissions par mois calendaire, trois soumissions actives au maximum à tout moment (cette seconde limite existe depuis 2024). Le quota vaut pour toutes les catégories, et les papiers rejetés comptent : soumettre deux papiers refusés en un mois oblige à attendre le mois suivant.
Quelques assouplissements : un papier encore « on hold » le mois suivant ne mange pas le quota mensuel de ce nouveau mois, mais reste compté dans les trois actives. Un papier supprimé avant son annonce ne compte nulle part.
La limite s'applique au soumetteur uniquement. Une équipe de co-auteurs peut donc répartir ses dépôts entre plusieurs membres, ce qu'arXiv invite d'ailleurs explicitement à coordonner. Pour les échéances de conférence ou les arriérés, la consigne est simple : planifier.
Une mesure provisoire, assumée comme telle
arXiv qualifie la politique de stopgap, une solution d'attente le temps de définir ce que pourraient être les bonnes pratiques pour des auteurs utilisant des outils d'IA de plus en plus avancés.
Le dépôt promet de suivre les effets de la mesure sur les auteurs, les lecteurs et le corpus, et de l'ajuster si nécessaire. Il espère aussi un effet incitatif : pousser les chercheurs à ne soumettre que leurs meilleurs travaux.
“With AI tools becoming more advanced and accessible to authors, the “practical limit” of how many papers can be submitted is now up for debate.”
“AI tools are making it easy for authors to flood arXiv and other repositories with these low-value papers.”
“A relatively small proportion of authors are submitting a large number of low-quality papers and consuming a disproportionate fraction of the moderators’ time. — Thomas Dietterich”
Pourquoi ça compte
arXiv est l'infrastructure de facto de la recherche en IA : c'est là que sortent les papiers qui font bouger le secteur, souvent bien avant toute revue par les pairs. Le voir instaurer un quota uniforme est un aveu important : la production scientifique assistée par IA a déplacé le goulot d'étranglement de l'écriture vers la vérification, et ce sont des bénévoles qui encaissent. La mesure est défendable sur le principe d'équité, mais elle reste un instrument grossier. Elle pénalise aussi les chercheurs prolifiques et légitimes, et ceux qui jonglent avec les calendriers de conférences. Elle est en outre contournable par simple répartition des dépôts entre co-auteurs, ce que la FAQ admet presque en creux. Surtout, elle traite le volume, pas la qualité : un quota de deux papiers n'empêche pas deux papiers médiocres générés par IA. Le vrai chantier, que arXiv reconnaît en parlant d'outils de modération à améliorer, sera de détecter la faible valeur à grande échelle sans transformer un dépôt ouvert en revue fermée. D'autres plateformes en open access, confrontées à la même vague, regarderont de près le résultat.
Compte gratuit
Vous venez de lire un article d'AI Sources
Créez un compte gratuit : un mois d'archives en entier, vos propres sources résumées comme celle-ci, vos notes et surlignages.
Pour vous
Faites-la travailler sur vos sources.
Gratuit : un mois d'articles et trois de vos sources. Pro : l'archive complète et vos sources, dès 8 €/mois.
Pour votre équipe
La même machine, sur vos sujets.
Un espace à vos couleurs, vos angles de veille, vos curateurs. Pilote ouvert à trois entreprises.
À lire aussi
 #superintelligenceHier
Hinton, Bengio, OpenAI et Anthropic signent un plan contre l'explosion d'intelligence
Vingt-deux chercheurs, dont des cadres d'OpenAI et d'Anthropic, estiment que l'automatisation de la recherche en IA pourrait comprimer des années de progrès en quelques mois, et que les États n'y sont pas préparés.
Source · Cambridge Programme on AI Science & Policy (CASP) · What if automating AI R&D triggers an intelligence explosion?
 #évaluation1 oct.
Piloter un LLM a un prix : Apple mesure ce que le steering coûte en fluidité
Une étude d'Apple et de l'université Pompeu Fabra montre que les méthodes de contrôle les plus efficaces sont souvent celles qui abîment le plus le texte produit.
Source · Apple Machine Learning Research · On the Effectiveness-Fluency Trade-Off in LLM Conditioning: A Systematic Study
 #google30 sept.
Diffusion Controller : Google unifie le pilotage des générateurs d'images
Google Research transforme le débruitage en problème de contrôle continu et propose un « amortisseur de direction » capable de piloter même un modèle fermé.
Source · Google Research Blog · How Diffusion Controller unifies and simplifies AI image generation