El precio del pensamiento artificial cae 13 veces al año, un récord histórico
Epoch AI midió la velocidad a la que un nivel dado de rendimiento de IA se vuelve barato. Ninguna tecnología disruptiva ha bajado nunca tan rápido.
En breve
Según Epoch AI, el coste para alcanzar un nivel de rendimiento dado en cinco benchmarks (matemáticas, ciencias, juegos) ha bajado alrededor de un 47% por trimestre desde 2023, es decir, un factor de 13 al año. Es mucho más rápido que la electricidad, las baterías, el compute o la secuenciación de ADN. La caída es aún más brutal justo después de que un nivel de rendimiento se convierte en estado del arte, lo que dice mucho sobre la fragilidad de los márgenes de los laboratorios.
🍺 Versión de barra
Responder a un test tipo test de física de nivel doctorado costaba 30 céntimos a principios de 2025; dieciocho meses después, cuesta cuatro centésimas de céntimo. Es como si tu coche nuevo pasara de 50.000 a 69 dólares, y el concesionario lo viera de lo más normal. La electricidad tardó ochenta años en hacerlo mucho peor, y nunca supo jugar al ajedrez. Pero que sea más barato no significa que se gaste menos: cuando algo se vuelve casi gratis, acabas pidiendo un millón.
Para recordar
- 1
Desde 2023, el coste de un nivel fijo de rendimiento de IA baja alrededor de un 47% por trimestre, es decir 13x al año, de media sobre cinco benchmarks: FrontierMath (niveles 1-3), OTIS Mock AIME, GPQA Diamond, Chess Puzzles y Mystery Game Puzzles.
- 2
Las matemáticas bajan más rápido (50-52% por trimestre, 16-19x al año), los puzzles de juegos lo hacen más lento (39-43%, 7-10x al año).
- 3
Ejemplo destacado: un 75% en GPQA Diamond costaba unos 0,30 $ por pregunta con o3 (enero de 2025), y luego 0,0004 $ con GPT-5.6 Luna menos de 18 meses después, una caída de 725x.
- 4
Justo después de que un nivel de rendimiento se convierte en estado del arte, el coste cae un 66% por trimestre (75x al año); dos años después, la caída se ralentiza a un 32% por trimestre (4,7x al año).
- 5
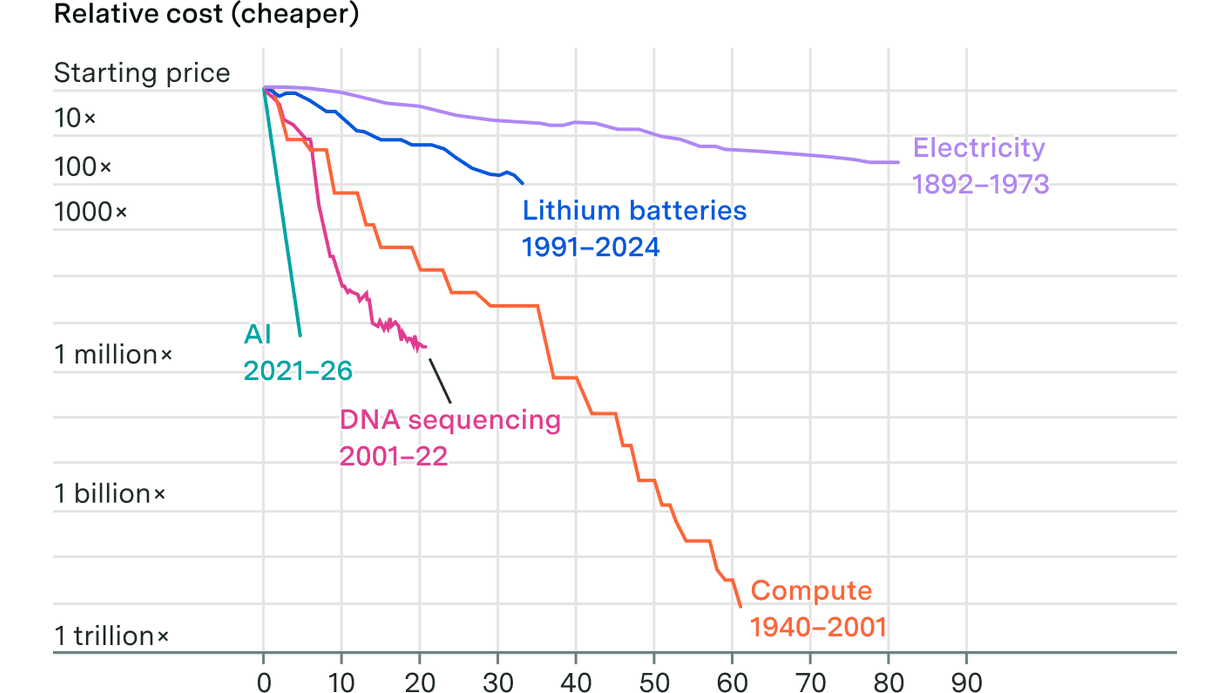
En puntos logarítmicos, la inferencia de LLM bajó 4 veces más rápido que la secuenciación de ADN, 6 veces más rápido que el compute, 18 veces más rápido que las baterías de litio-ion y 54 veces más rápido que la electricidad.
- 6
El método reconstruye toda la curva coste-rendimiento de cada modelo a partir de las transcripciones de los benchmarks, siguiendo un procedimiento del Center for AI Standards and Innovation (CAISI).
- 7
Los propios autores enumeran las limitaciones: benchmaxxing, la brecha entre benchmark y trabajo útil, usuarios reales que no cambian de modelo constantemente, y solo tres años de datos.
Un precio de salida que se desploma mientras los insumos se disparan
El boom de la IA hace subir el precio de lo que consume: chips, electricidad, e incluso la mano de obra de los electricistas. Epoch AI se interesa por el reverso paradójico de este fenómeno: el precio de lo que producen los centros de datos baja a una velocidad inédita.
El ejemplo elegido es elocuente. A finales de enero de 2025, o3 alcanzaba un 75% en GPQA Diamond, un test tipo test de física, química y biología de nivel doctorado, por unos 30 céntimos por pregunta. Menos de 18 meses después, GPT-5.6 Luna obtiene la misma puntuación por 0,0004 $.
Es decir, una caída de 725x. El informe lo traduce en imagen: un coche nuevo cuyo precio pasara de 50.000 a 69 dólares.
Medir el coste real, no el precio del token
Los trabajos anteriores razonaban en precio por token: Guido Appenzeller (a16z) encontraba 10x al año, un primer análisis de Epoch en marzo de 2025 entre 9 y 900x según los benchmarks. Los modelos de razonamiento, lanzados con o1, dejaron cojo este enfoque: consumen muchos más tokens pero se apoyan en modelos más pequeños y baratos por token.
Epoch mide por tanto el coste real para alcanzar una puntuación. En lugar de hacer correr cada modelo con todos los presupuestos posibles, el equipo retoma un método del CAISI: a partir de una ejecución sin restricciones, se cuentan las preguntas resueltas correctamente bajo un presupuesto X de tokens, puntuando las demás al azar. Así se obtiene una curva completa de rendimiento-gasto.
Para evitar sesgos, el equipo rellenó sus huecos de datos probando modelos con bajo esfuerzo de razonamiento y modelos pequeños y eficientes, incluidos modelos de pesos abiertos alojados en hardware alquilado. Validación: en cinco modelos también disponibles vía API, la diferencia entre coste directo y precio de API se mantiene por debajo del 30%.
Modelos estadísticos asumidos como aproximados
El objeto de estudio es la frontera de Pareto: el modelo más barato capaz de alcanzar cada nivel de rendimiento en una fecha dada. Una frontera inestable por naturaleza, que un solo resultado añadido o faltante puede desplazar durante meses.
Epoch probó varios enfoques: ajuste suavizado de la frontera, envolvente restringida, regresión sobre todos los datos, análisis de frontera estocástica. El modelo elegido es un ajuste Box-Tidwell de la frontera de costes, que se ajusta a los datos sin producir inversiones absurdas. Los demás dan a veces resultados implausibles, como costes que aumentan.
Los autores renuncian explícitamente a los intervalos de confianza y al bootstrap, considerados engañosos en este contexto. La cifra del 47% coincide exactamente con la media calculada sin modelo, lo que refuerza su credibilidad.
La prima del estado del arte no dura
En tres de los cinco benchmarks principales (AIME, FrontierMath, GPQA Diamond), el coste cae más rápido justo después de que un nivel de rendimiento se alcanza por primera vez. En promedio: 66% por trimestre en el momento en que ese nivel se convierte en SOTA, 32% dos años después.
La explicación propuesta: el laboratorio que logra un nuevo récord cobra brevemente una prima, antes de que la competencia y los avances técnicos aplasten el precio. Los puzzles de ajedrez y de juego misterioso son la excepción, con una ligera aceleración.
Detalle notable: la competencia más feroz cerca del estado del arte enfrenta sobre todo a modelos cerrados. Solo un modelo de pesos abiertos, QwQ-32B, aparece en segunda posición en los ejemplos estudiados, aunque la presión del open source pueda jugar indirectamente.
Una caída sin equivalente histórico
Epoch considera plausible que este ritmo dure desde noviembre de 2021, fecha de apertura comercial de la API de GPT-3. Un indicio: GPT-3 obtenía 43,9 en MMLU por 60 $ el millón de tokens; Llama 2-7B lograba 45,3 en julio de 2023 por 0,20 $, es decir, una caída de 31x al año.
En comparación, el precio residencial de la electricidad en Estados Unidos bajó 1,05x al año entre 1892 y 1973, las baterías de litio-ion 1,16x (1991-2024), el compute 1,51x (1940-2001), la secuenciación de ADN 1,84x (2001-2025).
Las limitaciones, planteadas por los propios autores
Primer riesgo: el benchmaxxing, el entrenamiento dirigido específicamente a los benchmarks conocidos. Mystery Game Puzzles, cuyo juego se mantiene en secreto para evitarlo, muestra una caída algo más lenta (44% frente a 47%), lo que sugiere una crítica «válida pero no fatal».
Además, un benchmark no es trabajo útil, y ningún usuario real alterna constantemente entre modelos para mantenerse en la frontera de costes. Tres años de datos es poco tiempo, y las opciones de cálculo de la media hacen variar el resultado entre 42,9% y 58% por trimestre.
Por último, precio a la baja no significa gasto a la baja: una tarea como verificar miles de artículos científicos podría exigir el equivalente a un millón de ejecuciones de benchmark. Y si aprobar un test de matemáticas de primaria se ha vuelto gratis, demostrar teoremas difíciles no lo es.
“That is a 725-fold drop in the price of thought in under 18 months.”
“The price of passing a first-grade math test may now be trivial. The price of proving hard theorems is not.”
“Supra-normal profits in LLM service provision may be fleeting for any given model.”
Por qué importa
Este informe da un orden de magnitud sólido a una intuición difusa: la inteligencia de un nivel dado se está convirtiendo en una mercancía a una velocidad sin precedentes. Dos consecuencias merecen atención. Primero, la ventana de rentabilidad de un modelo de vanguardia se cierra en pocos trimestres, lo que explica la carrera desenfrenada entre laboratorios e interroga la viabilidad de modelos de negocio basados en márgenes premium. Segundo, la bajada de los precios unitarios no dice nada sobre la factura total: si el uso se dispara (agentes, razonamiento largo, procesamiento masivo), la demanda de compute puede seguir creciendo, lo que reconcilia estas cifras con las inversiones colosales en centros de datos. La honestidad metodológica de Epoch merece reconocimiento, pero hay que leer el «13x al año» como una medida de lo que es posible para un comprador perfectamente optimizador sobre benchmarks académicos, no como la bajada de coste vivida por una empresa que despliega un asistente de código. El SWE-bench Verified, más cercano al trabajo real, «solo» baja un 27,5% por trimestre.
Para ti
Ponla a trabajar con tus fuentes.
Gratis: los artículos de la semana y tres fuentes tuyas. Pro: todo el archivo y tus fuentes, desde 8 €/mes.
Para tu equipo
La misma máquina, sobre tus temas.
Un espacio con tus colores, tus ángulos de vigilancia, tus curadores. Piloto abierto a tres empresas.
Sigue leyendo
 #anthropicHoy
Claude Opus 5.5: más potente, 40 % más barato de ejecutar
Anthropic lanza su primer modelo desde su llamado a «desacelerar la frontera» — y pone la eficiencia en el centro del discurso.
Fuente · Anthropic · Introducing Claude Opus 5.5
 #apiHoy
GPT-6 Sol y Luna: OpenAI reduce a la mitad sus precios de API
Tras Astra, OpenAI despliega su nueva generación en dos modelos más baratos y ataca frontalmente a Claude en la relación coste/inteligencia.
Fuente · OpenAI · Introducing GPT-6 Sol and Luna
 #iaAyer
En el 46 % de las empresas, el director de RR. HH. no está en la sala
El estudio CHRO 2026 de IBM cuantifica lo que separa a las empresas que convierten la IA en crecimiento de las que la convierten en ahorros.
Fuente · IBM Institute for Business Value · Designing the Thinking Organization — 2026 CHRO Study