Il prezzo del pensiero artificiale crolla di 13 volte all'anno, un record storico
Epoch AI ha misurato la velocità con cui un dato livello di performance IA diventa economico. Nessuna tecnologia dirompente è mai scesa così in fretta.
In breve
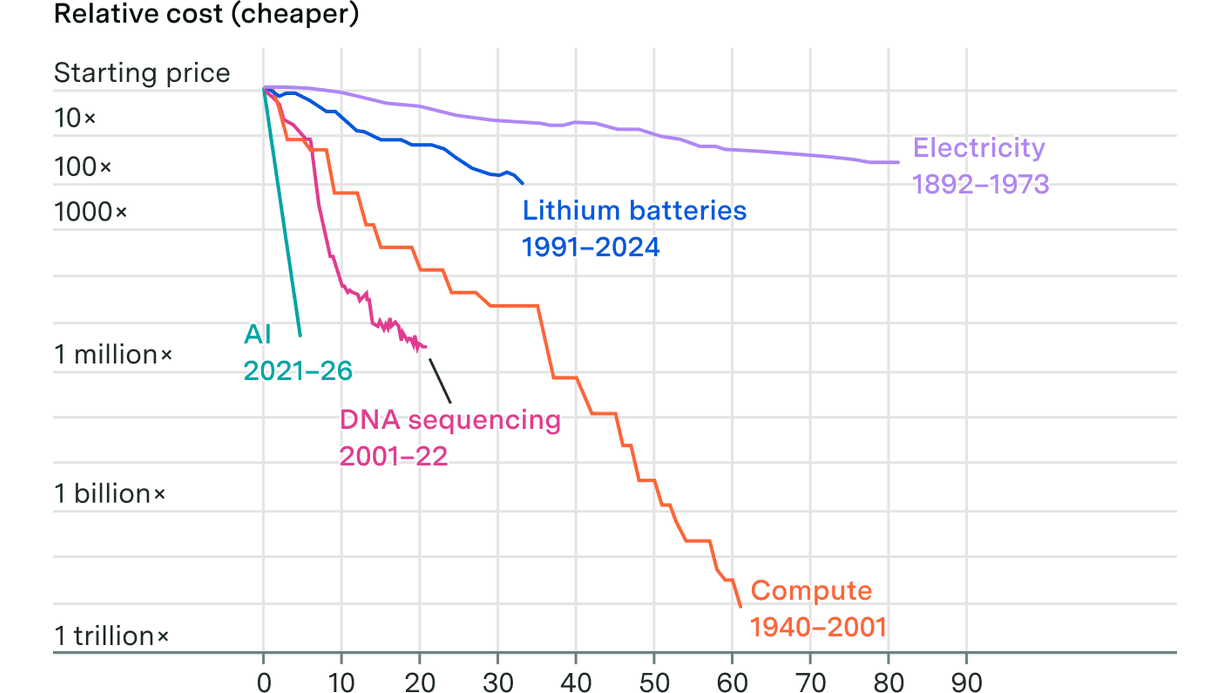
Secondo Epoch AI, il costo per raggiungere un dato livello di performance su cinque benchmark (matematica, scienze, giochi) è calato di circa il 47% a trimestre dal 2023, cioè un fattore 13 all'anno. È molto più rapido dell'elettricità, delle batterie, del compute o del sequenziamento del DNA. Il calo è ancora più violento subito dopo che un livello di performance diventa lo stato dell'arte, il che la dice lunga sulla fragilità dei margini dei laboratori.
🍺 Versione da bancone
Rispondere a una domanda di fisica livello dottorato costava 30 centesimi a inizio 2025; diciotto mesi dopo, costa quattro centesimi di centesimo. È come se la tua auto nuova passasse da 50.000 a 69 dollari, e il concessionario trovasse tutto normale. All'elettricità ci sono voluti ottant'anni per fare molto peggio, e non ha mai saputo giocare a scacchi. Peccato che più economico non significhi meno spesa: quando una cosa diventa quasi gratis, finisci per ordinarne un milione.
Da ricordare
- 1
Dal 2023, il costo per un livello fisso di performance IA cala di circa il 47% a trimestre, cioè 13x all'anno, in media su cinque benchmark: FrontierMath (tier 1-3), OTIS Mock AIME, GPQA Diamond, Chess Puzzles e Mystery Game Puzzles.
- 2
La matematica cala più velocemente (50–52% a trimestre, 16–19x all'anno), i puzzle di gioco meno velocemente (39–43%, 7–10x all'anno).
- 3
Esempio emblematico: 75% su GPQA Diamond costava circa 0,30 $ a domanda con o3 (gennaio 2025), poi 0,0004 $ con GPT-5.6 Luna meno di 18 mesi dopo, un calo di 725x.
- 4
Subito dopo che un livello di performance diventa lo stato dell'arte, il costo crolla del 66% a trimestre (75x all'anno); due anni dopo, il calo rallenta al 32% a trimestre (4,7x all'anno).
- 5
In log points, l'inferenza LLM è calata 4 volte più velocemente del sequenziamento del DNA, 6 volte più velocemente del compute, 18 volte più velocemente delle batterie agli ioni di litio e 54 volte più velocemente dell'elettricità.
- 6
Il metodo ricostruisce l'intera curva costo-performance di ogni modello a partire dai transcript dei benchmark, seguendo una procedura del Center for AI Standards and Innovation (CAISI).
- 7
Gli autori stessi elencano i limiti: benchmaxxing, divario tra benchmark e lavoro utile, utenti reali che non cambiano modello di continuo, e solo tre anni di dati.
Un prezzo di uscita che crolla mentre gli input volano
Il boom dell'IA fa salire il prezzo di ciò che consuma: chip, elettricità, persino la manodopera degli elettricisti. Epoch AI si interessa al rovescio paradossale di questo fenomeno: il prezzo di ciò che i data center producono cala a una velocità inedita.
L'esempio scelto è eloquente. A fine gennaio 2025, o3 raggiungeva il 75% su GPQA Diamond, un test a scelta multipla di fisica, chimica e biologia livello dottorato, per circa 30 centesimi a domanda. Meno di 18 mesi dopo, GPT-5.6 Luna ottiene lo stesso punteggio per 0,0004 $.
Un calo di 725x. Il rapporto lo traduce con un'immagine: un'auto nuova il cui prezzo passerebbe da 50.000 a 69 dollari.
Misurare il costo reale, non il prezzo del token
I lavori precedenti ragionavano in prezzo per token: Guido Appenzeller (a16z) trovava 10x all'anno, una prima analisi di Epoch nel marzo 2025 tra 9 e 900x a seconda dei benchmark. I modelli di ragionamento, lanciati con o1, hanno reso quest'approccio traballante: consumano molti più token ma si basano su modelli più piccoli e meno costosi per token.
Epoch misura quindi il costo reale per raggiungere un punteggio. Invece di far girare ogni modello con tutti i budget possibili, il team riprende un metodo del CAISI: partendo da un run senza vincoli, si contano le domande risolte correttamente sotto un budget X di token, mentre le altre vengono valutate a caso. Si ottiene così una curva costo-performance completa.
Per evitare distorsioni, il team ha colmato i vuoti nei dati testando modelli con basso sforzo di ragionamento e piccoli modelli efficienti, inclusi modelli open weight ospitati su hardware noleggiato. Validazione: su cinque modelli disponibili anche via API, lo scarto tra costo diretto e prezzo API resta sotto il 30%.
Modelli statistici assunti come approssimativi
L'oggetto studiato è la frontiera di Pareto: il modello meno costoso capace di raggiungere ogni livello di performance a una data data. Una frontiera instabile per natura, che un solo risultato aggiunto o mancante può spostare per mesi.
Epoch ha testato diversi approcci: adattamento levigato della frontiera, inviluppo vincolato, regressione su tutti i dati, analisi di frontiera stocastica. Il modello scelto è un adattamento Box-Tidwell della frontiera dei costi, che aderisce ai dati senza produrre inversioni assurde. Gli altri danno a volte risultati implausibili, come costi che aumentano.
Gli autori rinunciano esplicitamente agli intervalli di confidenza e al bootstrap, giudicati fuorvianti in questo contesto. La cifra del 47% coincide esattamente con la media calcolata senza modello, il che rafforza la sua credibilità.
Il premio dello stato dell'arte non dura
Su tre dei cinque benchmark principali (AIME, FrontierMath, GPQA Diamond), il costo cala più velocemente subito dopo che un livello di performance viene raggiunto per la prima volta. In media: 66% a trimestre nel momento in cui quel livello diventa SOTA, 32% due anni dopo.
La spiegazione avanzata: il laboratorio che ottiene un nuovo record fa pagare brevemente un premio, prima che la concorrenza e i progressi tecnici schiaccino il prezzo. I puzzle di scacchi e del gioco misterioso fanno eccezione, con una lieve accelerazione.
Dettaglio notevole: la concorrenza più feroce vicino allo stato dell'arte oppone soprattutto modelli chiusi. Un solo modello open weight, QwQ-32B, appare in seconda posizione negli esempi studiati, anche se la pressione dell'open source può giocare indirettamente.
Un calo senza equivalente storico
Epoch stima plausibile che questo ritmo duri dal novembre 2021, data di apertura commerciale dell'API GPT-3. Indizio: GPT-3 otteneva 43,9 su MMLU per 60 $ al milione di token; Llama 2-7B faceva 45,3 nel luglio 2023 per 0,20 $, un calo di 31x all'anno.
In confronto, il prezzo residenziale dell'elettricità negli Stati Uniti è calato di 1,05x all'anno tra il 1892 e il 1973, le batterie agli ioni di litio di 1,16x (1991–2024), il compute di 1,51x (1940–2001), il sequenziamento del DNA di 1,84x (2001–2025).
I limiti, posti dagli stessi autori
Primo rischio: il benchmaxxing, l'addestramento mirato sui benchmark noti. Mystery Game Puzzles, il cui gioco è tenuto segreto per evitarlo, mostra un calo un po' più lento (44% contro 47%), il che suggerisce una critica «valida ma non fatale».
Inoltre, un benchmark non è lavoro utile, e nessun utente reale passa continuamente da un modello all'altro per restare sulla frontiera dei costi. Tre anni di dati sono pochi, e le scelte di media fanno variare il risultato tra il 42,9% e il 58% a trimestre.
Infine, prezzo in calo non significa spesa in calo: un compito come verificare migliaia di articoli scientifici potrebbe richiedere l'equivalente di un milione di run di benchmark. E se superare un test di matematica delle elementari è diventato gratuito, dimostrare teoremi difficili non lo è.
“That is a 725-fold drop in the price of thought in under 18 months.”
“The price of passing a first-grade math test may now be trivial. The price of proving hard theorems is not.”
“Supra-normal profits in LLM service provision may be fleeting for any given model.”
Perché conta
Questo rapporto dà un ordine di grandezza solido a un'intuizione diffusa: l'intelligenza di un dato livello sta diventando una commodity a una velocità senza precedenti. Due conseguenze meritano attenzione. Prima, la finestra di redditività di un modello di punta si chiude in pochi trimestri, il che spiega la corsa sfrenata tra i laboratori e mette in dubbio la sostenibilità di modelli di business basati su margini premium. Poi, il calo dei prezzi unitari non dice nulla sulla fattura totale: se l'uso esplode (agenti, ragionamento lungo, elaborazione massiva), la domanda di compute può continuare a crescere, il che riconcilia queste cifre con gli investimenti colossali nei data center. L'onestà metodologica di Epoch va lodata, ma va letto il «13x all'anno» come una misura di ciò che è possibile per un acquirente perfettamente ottimizzatore su benchmark accademici, non come il calo di costo vissuto da un'azienda che distribuisce un assistente di codice. Lo SWE-bench Verified, più vicino al lavoro reale, cala infatti «solo» del 27,5% a trimestre.
Per te
Falla lavorare sulle tue fonti.
Gratis: gli articoli della settimana e tre fonti tue. Pro: tutto l'archivio e le tue fonti, da 8 €/mese.
Per il tuo team
La stessa macchina, sui vostri temi.
Uno spazio con i vostri colori, i vostri angoli di monitoraggio, i vostri curatori. Pilota aperto a tre aziende.
Da leggere anche
 #anthropicOggi
Claude Opus 5.5: più potente, il 40% più economico da eseguire
Anthropic lancia il suo primo modello dopo l'appello a «rallentare la frontiera» — e mette l'efficienza al centro del discorso.
Fonte · Anthropic · Introducing Claude Opus 5.5
 #apiOggi
GPT-6 Sol e Luna: OpenAI dimezza i prezzi dell'API
Dopo Astra, OpenAI declina la nuova generazione in due modelli più economici e attacca frontalmente Claude sul rapporto costo/intelligenza.
Fonte · OpenAI · Introducing GPT-6 Sol and Luna
 #iaIeri
Nel 46% delle aziende, il direttore HR non è nella stanza
Lo studio CHRO 2026 di IBM quantifica ciò che separa le aziende che trasformano l'IA in crescita da quelle che la trasformano in tagli di costi.
Fonte · IBM Institute for Business Value · Designing the Thinking Organization — 2026 CHRO Study