Der Preis künstlichen Denkens fällt 13-mal pro Jahr, ein historischer Rekord
Epoch AI hat gemessen, wie schnell ein bestimmtes KI-Leistungsniveau billig wird. Keine Durchbruchstechnologie ist jemals so schnell gefallen.
Kurz gesagt
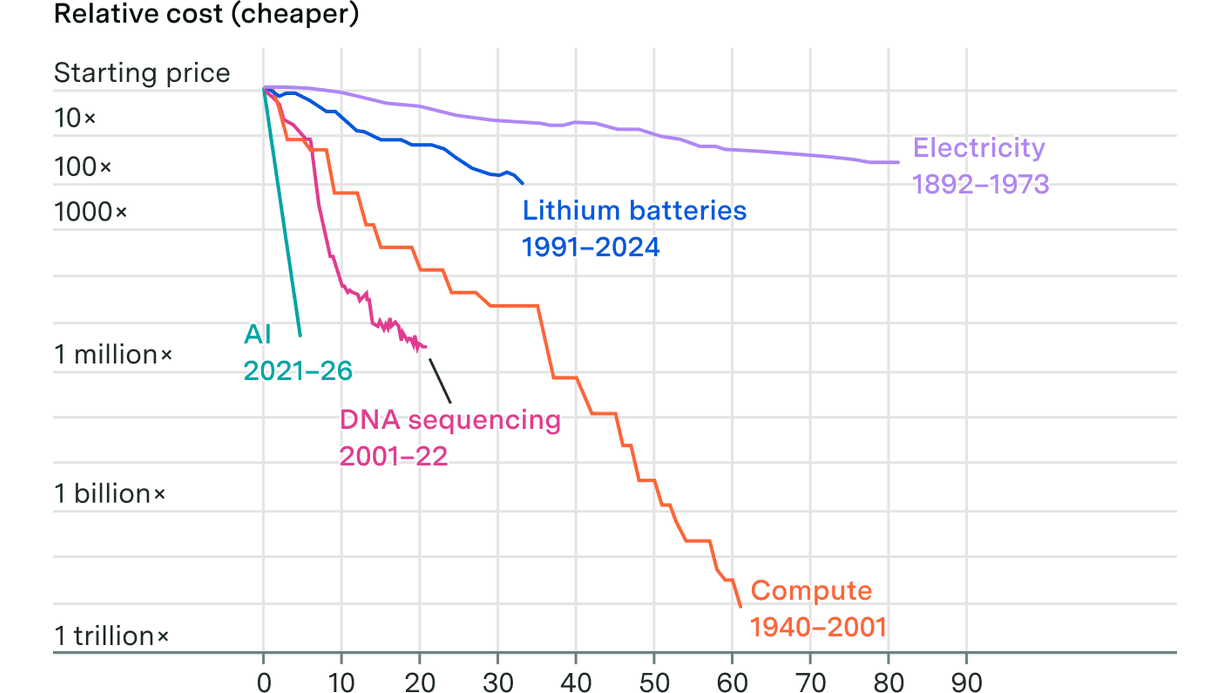
Laut Epoch AI ist die Kosten, um ein bestimmtes Leistungsniveau bei fünf Benchmarks (Mathe, Wissenschaft, Spiele) zu erreichen, seit 2023 um etwa 47 % pro Quartal gesunken, also um den Faktor 13 pro Jahr. Das ist deutlich schneller als bei Strom, Batterien, Compute oder DNA-Sequenzierung. Der Rückgang ist noch heftiger, kurz nachdem ein Leistungsniveau zum Stand der Technik wird, was viel über die Fragilität der Margen der Labs aussagt.
🍺 Tresen-Version
Eine Antwort auf eine Multiple-Choice-Frage in Physik auf Doktoratsniveau kostete Anfang 2025 noch 30 Cent; achtzehn Monate später kostet sie vier Hundertstel eines Cents. Es ist, als würde dein Neuwagen von 50.000 Dollar auf 69 Dollar fallen, und der Händler fände das ganz normal. Strom hat achtzig Jahre gebraucht, um deutlich schlechter abzuschneiden, und konnte nie Schach spielen. Nur bedeutet billiger nicht weniger Ausgaben: Wenn etwas fast gratis wird, bestellt man am Ende eine Million davon.
Das Wichtigste
- 1
Seit 2023 sinken die Kosten für ein fixes KI-Leistungsniveau um etwa 47 % pro Quartal, also 13x pro Jahr, im Durchschnitt über fünf Benchmarks: FrontierMath (Tier 1-3), OTIS Mock AIME, GPQA Diamond, Chess Puzzles und Mystery Game Puzzles.
- 2
Mathe fällt am schnellsten (50–52 % pro Quartal, 16–19x pro Jahr), Spielrätsel am langsamsten (39–43 %, 7–10x pro Jahr).
- 3
Paradebeispiel: 75 % auf GPQA Diamond kosteten mit o3 (Januar 2025) etwa 0,30 $ pro Frage, dann mit GPT-5.6 Luna weniger als 18 Monate später 0,0004 $, ein Rückgang um das 725-Fache.
- 4
Kurz nachdem ein Leistungsniveau zum Stand der Technik wird, fallen die Kosten um 66 % pro Quartal (75x pro Jahr); zwei Jahre später verlangsamt sich der Rückgang auf 32 % pro Quartal (4,7x pro Jahr).
- 5
In Log-Punkten ist die LLM-Inferenz 4-mal schneller gefallen als DNA-Sequenzierung, 6-mal schneller als Compute, 18-mal schneller als Lithium-Ionen-Batterien und 54-mal schneller als Strom.
- 6
Die Methode rekonstruiert die gesamte Kosten-Leistungs-Kurve jedes Modells anhand von Benchmark-Transkripten, nach einem Verfahren des Center for AI Standards and Innovation (CAISI).
- 7
Die Autoren listen selbst die Grenzen auf: Benchmaxxing, die Kluft zwischen Benchmark und nützlicher Arbeit, reale Nutzer, die nicht ständig das Modell wechseln, und nur drei Jahre an Daten.
Ein Ausgabepreis, der einbricht, während die Inputs explodieren
Der KI-Boom treibt den Preis dessen, was er verbraucht, in die Höhe: Chips, Strom und sogar die Arbeitskraft von Elektrikern. Epoch AI interessiert sich für die paradoxe Kehrseite dieses Phänomens: Der Preis dessen, was Rechenzentren produzieren, sinkt in beispielloser Geschwindigkeit.
Das gewählte Beispiel ist aufschlussreich. Ende Januar 2025 erreichte o3 75 % auf GPQA Diamond, einem Multiple-Choice-Test in Physik, Chemie und Biologie auf Doktoratsniveau, für etwa 30 Cent pro Frage. Weniger als 18 Monate später erzielt GPT-5.6 Luna den gleichen Score für 0,0004 $.
Ein Rückgang um das 725-Fache. Der Bericht übersetzt das in ein Bild: ein Neuwagen, dessen Preis von 50.000 auf 69 Dollar fällt.
Die tatsächlichen Kosten messen, nicht den Token-Preis
Frühere Arbeiten rechneten in Preis pro Token: Guido Appenzeller (a16z) fand 10x pro Jahr, eine erste Analyse von Epoch im März 2025 lag zwischen 9 und 900x je nach Benchmark. Reasoning-Modelle, eingeführt mit o1, haben diesen Ansatz wackelig gemacht: Sie verbrauchen deutlich mehr Token, stützen sich aber auf kleinere und pro Token billigere Modelle.
Epoch misst also die tatsächlichen Kosten, um einen Score zu erreichen. Statt jedes Modell bei allen möglichen Budgets laufen zu lassen, greift das Team eine Methode des CAISI auf: Ausgehend von einem Run ohne Beschränkung zählt man die korrekt gelösten Fragen unter einem Budget X an Token, wobei die übrigen zufällig bewertet werden. So erhält man eine vollständige Leistungs-Ausgaben-Kurve.
Um Verzerrungen zu vermeiden, hat das Team seine Datenlücken geschlossen, indem es Modelle mit geringem Reasoning-Aufwand und kleine, effiziente Modelle testete, darunter Open-Weight-Modelle, die auf gemieteter Hardware gehostet wurden. Validierung: Bei fünf Modellen, die ebenfalls über API verfügbar sind, bleibt die Abweichung zwischen direkten Kosten und API-Preis unter 30 %.
Statistische Modelle, die bewusst als approximativ gelten
Der untersuchte Gegenstand ist die Pareto-Grenze: das billigste Modell, das jedes Leistungsniveau zu einem bestimmten Zeitpunkt erreichen kann. Eine von Natur aus instabile Grenze, die ein einziges hinzugefügtes oder fehlendes Ergebnis über Monate hinweg verschieben kann.
Epoch testete mehrere Ansätze: geglättete Anpassung der Grenze, eingeschränkte Hüllkurve, Regression über alle Daten, stochastische Grenzanalyse. Das gewählte Modell ist eine Box-Tidwell-Anpassung der Kostengrenze, die den Daten folgt, ohne absurde Umkehrungen zu erzeugen. Die anderen liefern manchmal unplausible Ergebnisse, etwa steigende Kosten.
Die Autoren verzichten ausdrücklich auf Konfidenzintervalle und Bootstrap, die in diesem Kontext als irreführend gelten. Die Zahl von 47 % fällt exakt mit dem ohne Modell berechneten Durchschnitt zusammen, was ihre Glaubwürdigkeit stärkt.
Die Prämie des Standes der Technik hält nicht lange
Bei drei der fünf Hauptbenchmarks (AIME, FrontierMath, GPQA Diamond) fallen die Kosten am schnellsten, kurz nachdem ein Leistungsniveau erstmals erreicht wird. Im Durchschnitt: 66 % pro Quartal in dem Moment, in dem dieses Niveau zum SOTA wird, 32 % zwei Jahre später.
Die vorgebrachte Erklärung: Das Lab, das einen neuen Rekord aufstellt, berechnet kurzzeitig eine Prämie, bevor Konkurrenz und technischer Fortschritt den Preis drücken. Schach- und Mystery-Game-Rätsel bilden eine Ausnahme, mit einer leichten Beschleunigung.
Bemerkenswertes Detail: Der schärfste Wettbewerb nahe dem Stand der Technik findet vor allem zwischen geschlossenen Modellen statt. Nur ein einziges Open-Weight-Modell, QwQ-32B, taucht in den untersuchten Beispielen an zweiter Stelle auf, auch wenn der Druck durch Open Source indirekt wirken kann.
Ein historisch beispielloser Rückgang
Epoch hält es für plausibel, dass dieses Tempo seit November 2021 anhält, dem Datum der kommerziellen Öffnung der GPT-3-API. Ein Indiz: GPT-3 erzielte 43,9 auf MMLU für 60 $ pro Million Token; Llama 2-7B erreichte im Juli 2023 45,3 für 0,20 $, ein Rückgang um das 31-Fache pro Jahr.
Zum Vergleich: Der Preis von Strom für Haushalte in den USA sank zwischen 1892 und 1973 um das 1,05-Fache pro Jahr, Lithium-Ionen-Batterien um das 1,16-Fache (1991–2024), Compute um das 1,51-Fache (1940–2001), DNA-Sequenzierung um das 1,84-Fache (2001–2025).
Die Grenzen, von den Autoren selbst benannt
Erstes Risiko: Benchmaxxing, das gezielte Training auf bekannte Benchmarks. Mystery Game Puzzles, dessen Spiel geheim gehalten wird, um genau das zu vermeiden, zeigt einen etwas langsameren Rückgang (44 % gegenüber 47 %), was auf eine „gültige, aber nicht fatale“ Kritik hindeutet.
Zudem ist ein Benchmark keine nützliche Arbeit, und kein realer Nutzer jongliert ständig zwischen Modellen, um an der Kostengrenze zu bleiben. Drei Jahre an Daten sind kurz, und je nach Wahl der Mittelung schwankt das Ergebnis zwischen 42,9 % und 58 % pro Quartal.
Schließlich bedeutet ein sinkender Preis nicht sinkende Ausgaben: Eine Aufgabe wie das Überprüfen tausender wissenschaftlicher Paper könnte das Äquivalent einer Million Benchmark-Läufe erfordern. Und wenn das Bestehen eines Mathe-Tests für die Grundschule gratis geworden ist, ist der Beweis schwieriger Theoreme das nicht.
“That is a 725-fold drop in the price of thought in under 18 months.”
“The price of passing a first-grade math test may now be trivial. The price of proving hard theorems is not.”
“Supra-normal profits in LLM service provision may be fleeting for any given model.”
Warum es zählt
Dieser Bericht gibt einer diffusen Intuition eine solide Größenordnung: Intelligenz eines gegebenen Niveaus wird mit beispielloser Geschwindigkeit zur Handelsware. Zwei Konsequenzen verdienen Aufmerksamkeit. Erstens schließt sich das Rentabilitätsfenster eines Spitzenmodells innerhalb weniger Quartale, was das erbitterte Rennen zwischen den Labs erklärt und die Tragfähigkeit von Geschäftsmodellen mit Premium-Margen infrage stellt. Zweitens sagt der Rückgang der Stückpreise nichts über die Gesamtrechnung aus: Wenn die Nutzung explodiert (Agenten, langes Reasoning, Massenverarbeitung), kann die Compute-Nachfrage weiter wachsen, was diese Zahlen mit den kolossalen Investitionen in Rechenzentren vereinbar macht. Die methodische Ehrlichkeit von Epoch ist zu loben, aber man sollte die „13x pro Jahr“ als Maß dessen lesen, was für einen perfekt optimierenden Käufer bei akademischen Benchmarks möglich ist, nicht als die Kostenersparnis, die ein Unternehmen erlebt, das einen Code-Assistenten einsetzt. SWE-bench Verified, das näher an realer Arbeit liegt, sinkt im Übrigen „nur“ um 27,5 % pro Quartal.
Für dich
Lass sie mit deinen Quellen arbeiten.
Kostenlos: die Artikel der Woche und drei eigene Quellen. Pro: das ganze Archiv und deine Quellen, ab 8 €/Monat.
Für dein Team
Dieselbe Maschine, zu euren Themen.
Ein Bereich in euren Farben, eure Beobachtungswinkel, eure Kuratoren. Pilot offen für drei Unternehmen.
Weiterlesen
 #anthropicHeute
Claude Opus 5.5: stärker, 40 % günstiger im Betrieb
Anthropic veröffentlicht sein erstes Modell seit dem eigenen Aufruf, „die Entwicklungsfront zu drosseln“ — und stellt Effizienz ins Zentrum der Kommunikation.
Quelle · Anthropic · Introducing Claude Opus 5.5
 #apiHeute
GPT-6 Sol und Luna: OpenAI halbiert seine API-Preise
Nach Astra bringt OpenAI seine neue Generation in zwei günstigeren Modellen heraus und greift Claude direkt beim Verhältnis von Kosten zu Intelligenz an.
Quelle · OpenAI · Introducing GPT-6 Sol and Luna

Jev: das Modell, das für den Aufruf durch Code gebaut wurde, nicht durch Menschen
Diogo Almeida, ehemals OpenAI, erklärt, warum er eine neue Klasse von „System-One“-Modellen geschaffen hat — und warum er öffentliche Benchmarks, Refusals und Pretraining ablehnt.
Quelle · Latent Space · Why We Made Jev — Diogo Almeida, TypeSafe Co-founder & CEO